有一次,我需要导出一份包含300万行的销售数据,并尝试将其保存为.xlsx格式。结果软件直接无法完成操作——并非运行卡顿,而是根本无法写入数据。这是因为Excel单张工作表的行数上限为1,048,576行。一旦超过该数值,无论电脑配置多高,都无法突破这一硬性限制。
这次经历促使我系统梳理了CSV、Excel和Parquet这三种常用数据格式的核心差异与适用场景。
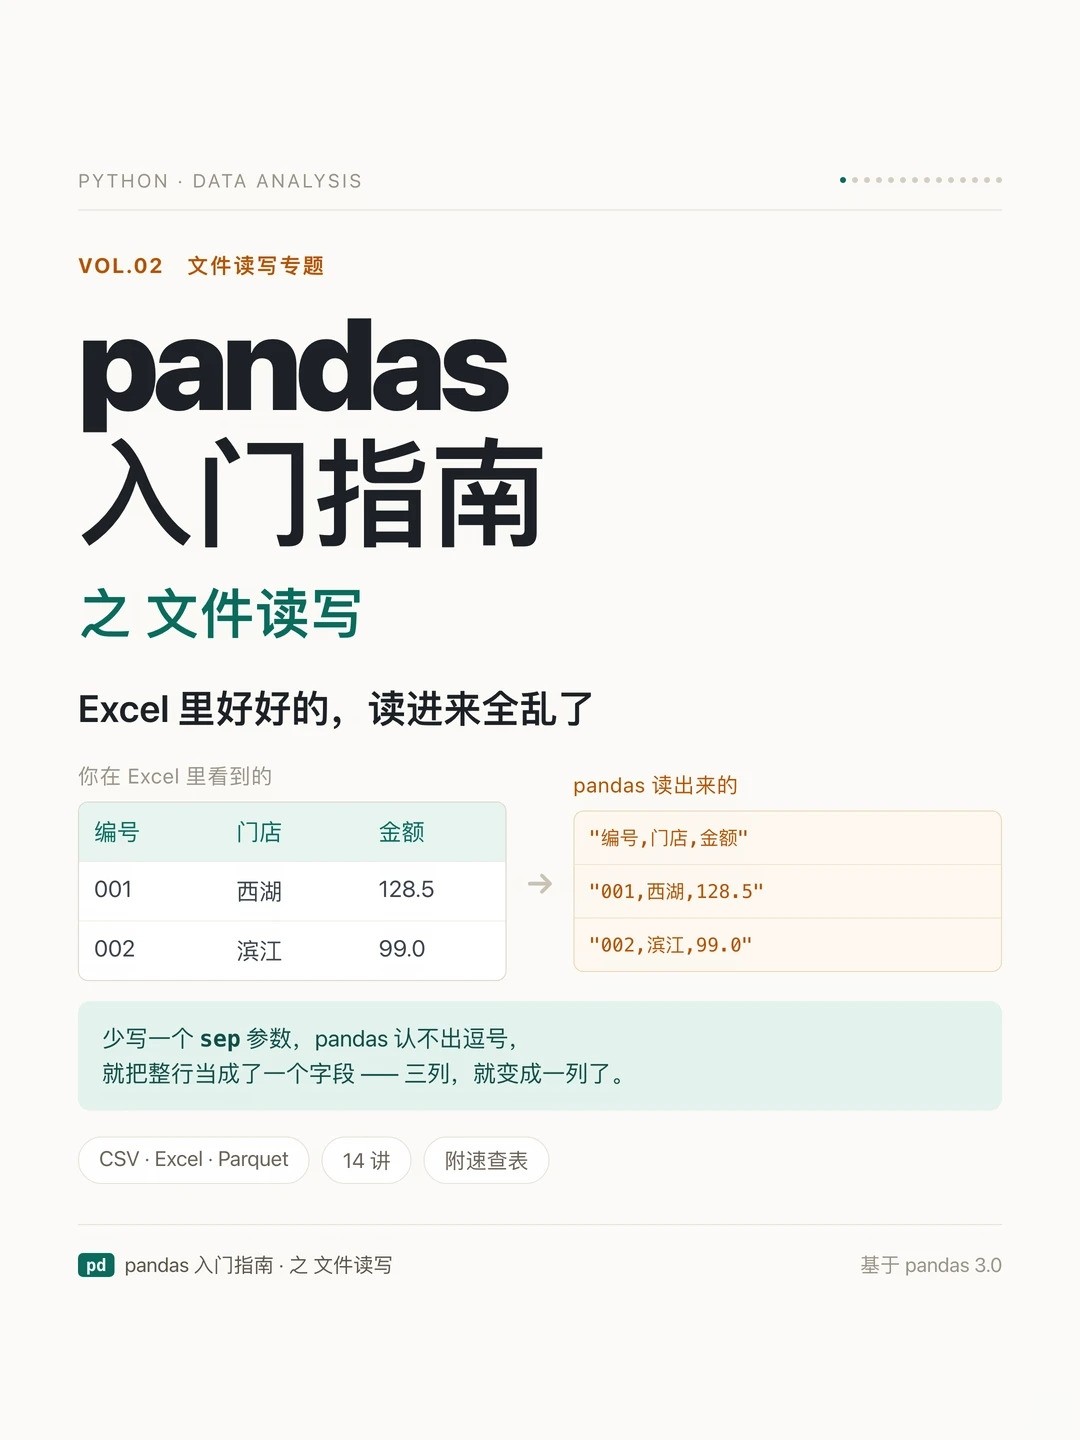
CSV是一种纯文本格式,兼容性强,几乎所有软件都能打开,但不保存数据类型信息,读取时需依赖程序自动推断,存在误判风险。
Excel(.xlsx)支持单元格格式、数据类型及多工作表结构,对人工查阅非常友好,但读写效率较低,且严格受限于单表1,048,576行的容量上限。
Parquet是二进制列式存储格式,具有体积小、读取快、类型保留完整等优势,特别适合机器反复读取与分析,但无法被常规办公软件直接打开。
因此,若目标是交付给人查看,优先选用Excel或CSV;若用于程序持续处理与建模,则Parquet是更优选择。
实际使用中还需注意几个关键细节:
其一,pandas中`sheet_name=None`会返回包含所有工作表的字典,而`sheet_name=0`仅返回第一张表的DataFrame,二者语义完全不同,误用将导致后续逻辑错误。
其二,`to_excel()`方法一次只能写入一张表;如需写入多张,必须使用`ExcelWriter`,且务必配合`with`语句确保文件正确关闭,否则生成的Excel可能损坏无法打开。
其三,读写Parquet文件需提前安装`pyarrow`库,缺失时会直接抛出`ImportError`,不会自动降级或提示替代方案。
其四,向已有Excel文件追加新工作表时,须显式设置`if_sheet_exists`参数,否则遇到同名工作表将触发报错。





 手机性能天梯图
 显卡天梯图
 CPU天梯图
 电源天梯图
 固态硬盘天梯图
 新品日历